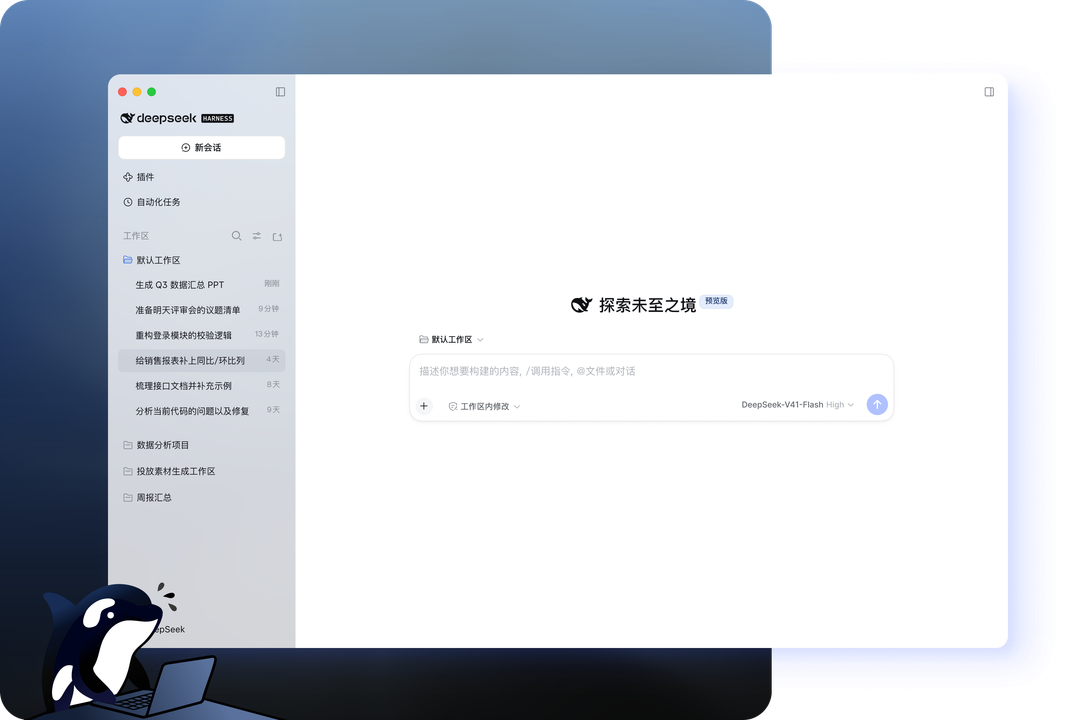
DeepSeek 官方网页版在线对话工作台
无需安装 · 零依赖开启 DeepSeek-R1 满血版显式推理链
DeepSeek-R1
纯强化学习 · 显式长推理链路
128K 超长上下文窗口
实时思维链回溯分析
纯强化学习数理求解
DeepSeek api开放平台协同
免登录即刻开启多轮问答
随时把长对话留在浏览器里
DeepSeek 网页版针对现代桌面与移动端浏览器进行了全方位渲染轻量化优化。无论是长达数万字的学术专著研读,还是复杂嵌套的代码重构推导,所有上下文在会话期间均保持稳定状态,随时可回溯、重问与导出。
配套提供智能前缀缓存技术,大幅提升多轮追问的生成速度,消除漫长等待,让深度求索随时在手指与屏幕之间自然发生。