SPEC // 01
MLA 潜在注意力
多头潜在注意力压缩机制大幅削减 KV Cache 显存开销,提供极致推理吞吐与极速的首字响应时间。
 DeepSeek
OFFICIAL
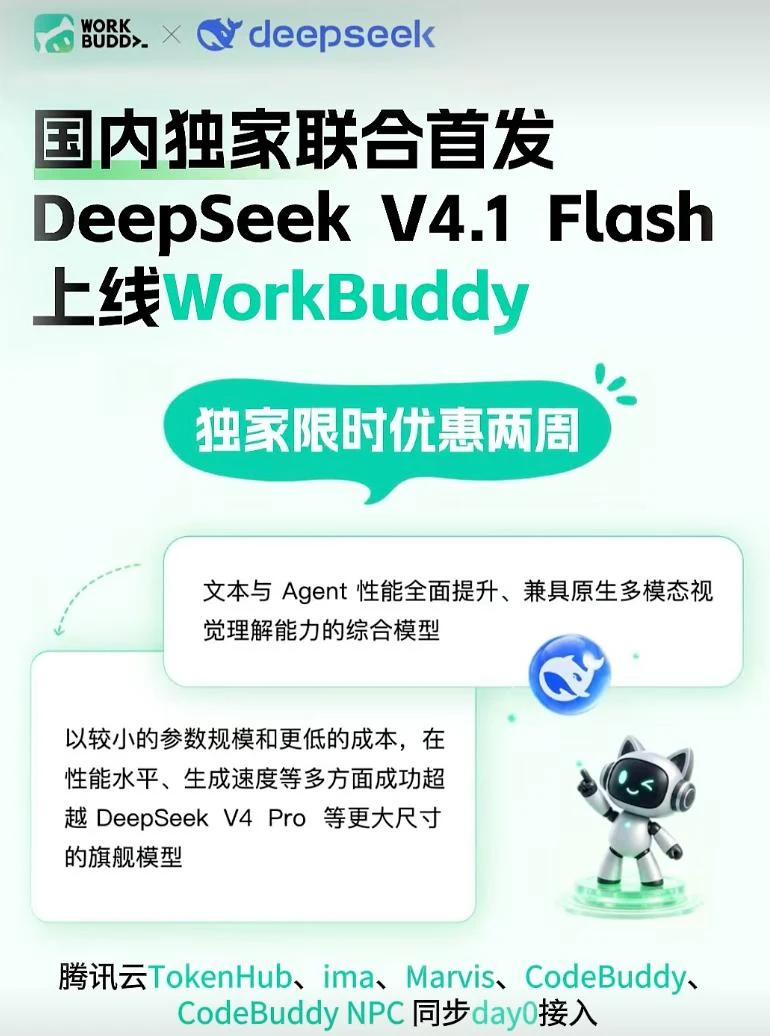
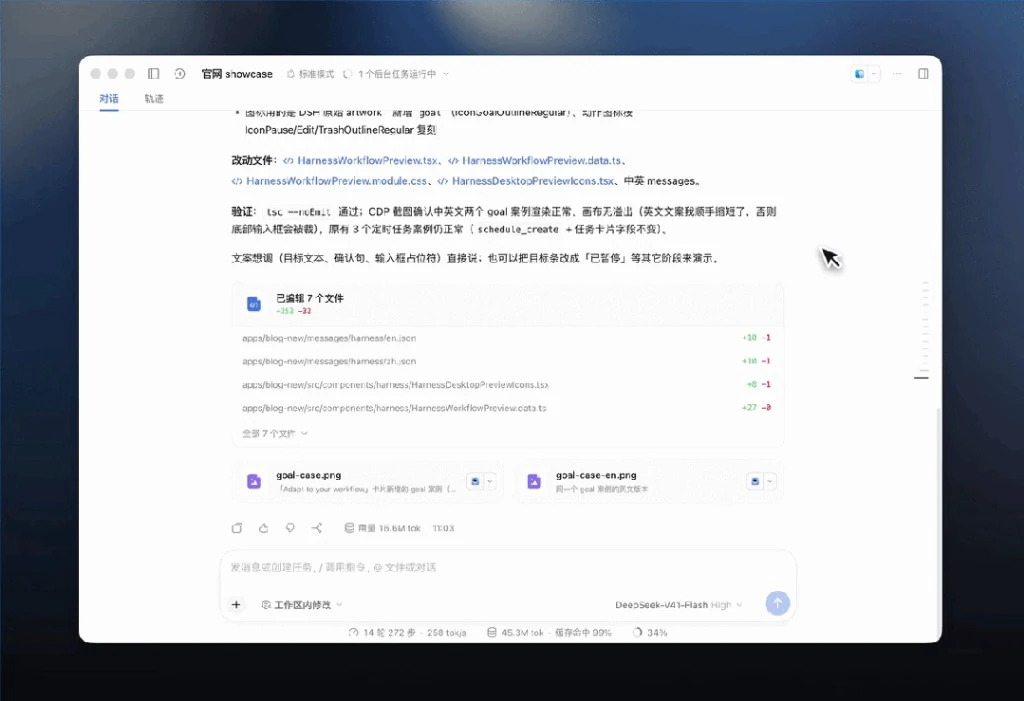
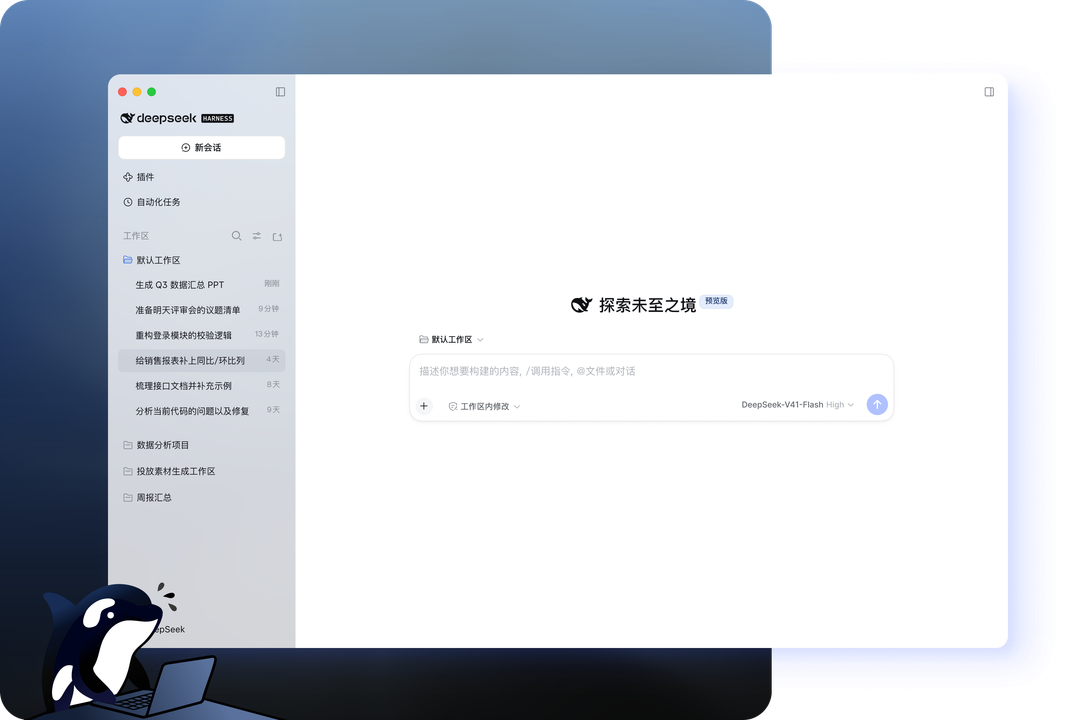
DeepSeek 与 Deep Seek 推出全新一代基于纯强化学习与大规模 MoE 稀疏激活的高性能推理大模型。通过便捷的 DeepSeek 网页版入口即可零门槛在线体验,开发者亦可经由 DeepSeek api开放平台接入超长 128K 上下文对话能力,搭配 DeepSeek Harness 离线双盲沙箱完成专业评测。
SPEC // TECHNICAL TRUST · 纯粹基于底层算法突破的全新推理引擎
多头潜在注意力压缩机制大幅削减 KV Cache 显存开销,提供极致推理吞吐与极速的首字响应时间。
无须人类反馈的强化学习冷启动,通过自博弈与验证机制自发涌现长链条回溯、自我纠错与验证思维。
总参数 671B,每个 Token 仅激活 37B 参数。细粒度专家路由在保障强悍智能的同时兼顾低成本推理。
原生支持 128K 完整会话窗口,支持智能前缀缓存技术,大幅降低长文档多次查询的重复计费开销。
面向代码重构、数理演算与商业决策的认知加速闭环
深入分析数万行大型项目工程架构,自动定位隐蔽边界异常并生成单元测试,提供生产级重构建议。
长链条多分支演绎推理能力,支持几何推导、离散数论证明及复杂定理推演,思维步骤严谨闭环。
一键跨卷宗比对投资意向书与合规条款,实时检测对赌协议漏洞与潜在穿透风险,生成结构化摘要。
基于历史宏观数据与多因子模型进行归因分析,快速编写回测逻辑代码并优化参数边界。
配合标准 Function Calling 工具调用能力,构建自动化任务分解、搜索增强与长链路执行代理。
支持企业在隔离内网运行量化蒸馏版本(1.5B 至 70B),杜绝敏感数据外泄,自主掌控全流程。
选型做成横条 · 左型号、中规格、右入口 · 满足多元生产力接入要求
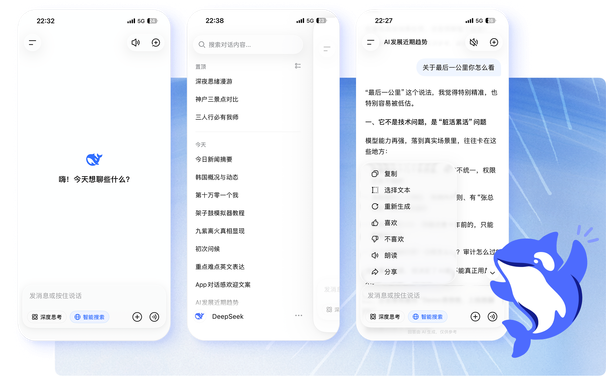
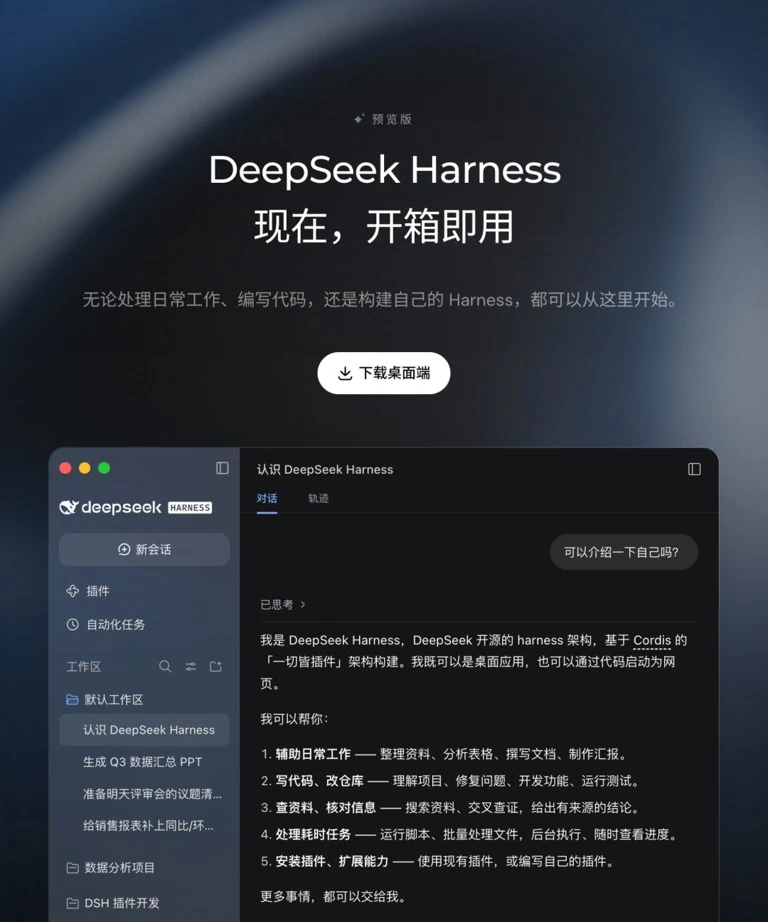
与既有代码无缝协同,几分钟内即可让业务系统拥有先进推理大脑
登录 DeepSeek 开发者中枢,在安全密钥面板中一键生成专享 API Key,支持多团队权限隔离与分账。
标准兼容 OpenAI SDK 调用规范,只需将 base_url 改写为官方接入端点,即可无感切换底层调用引擎。
开启 stream 响应并侦听 reasoning_content 字段,即刻将底层思考过程以毫秒级时延流式推送至前端。
用经得起检验的技术参数印证高可用工程实力
$ git clone https://github.com/deepseek-ai/harness.git
$ cd harness && pip install -r requirements.txt
> Loading benchmark: GSM8K_Hard, HumanEval_Plus, MATH-500
> Initializing dual-blind sandbox container...
> Running test: 500 questions with explicit reasoning chain check
[PASSED] Pass@1 Acc: 94.8% (Math) | Code Eval: 89.2%
> Zero data-leakage assertion verified.
> Report generated: /output/harness_benchmark_2026.json
题面随机加盐防作弊,真值留在企业内网金标准库中。杜绝训练集污染刷榜噪音,真实检验模型泛化水平。
不采用模糊相似度评分,而是自动调起 Python 沙箱或数理形式化校验器核对中间步骤与最终解,断言结果真实可靠。
关于服务使用、API 计费及安全隐私的权威回复
只需点击页面顶部或横幅处的【网页版入口】,即可直接使用现代浏览器登录对话界面,完整支持显式长思维链展示与多轮深度追问。
平台采用透明按量计费模式。对 64-Token 整数倍的提示词自动启用前缀缓存,缓存命中时的输入价格仅为未命中时的 10% 至 20%,大幅降低长期系统运行成本。
API 开放平台严格遵循商业数据隐私协议,所有企业调用数据默认绝不回流至训练集;私有化离线部署版本更可实现完全物理隔离,数据全程安全无虞。
支持。官方提供多种位宽量化权重与蒸馏模型版本,兼容 vLLM、Ollama 等业界主流推理引擎,在主流单机显卡或本地服务器上均可流畅跑通。